요약
본 가이드는 기업 및 조직이 인공지능(AI)을 실무 서비스에 안전하게 도입할 때 필수적으로 점검해야 하는 3대 핵심 분야, 즉 거버넌스(정책 및 위험관리), RAG(검색 증강 생성) 알고리즘 설계, 그리고 모델 파인튜닝(미세조정) 실무 절차를 다룹니다. 단순한 이론적 개념을 넘어 규제 준수, 시스템 아키텍처 설계, 최적의 비용 대비 성능 확보를 위한 구체적 실행 지침과 사례를 출처 근거에 기반하여 제시합니다.
1. 왜 거버넌스가 우선인가 — 핵심 원칙
인공지능 시스템 도입 과정에서 기술적 성능 구현보다 선행되어야 하는 것은 거버넌스 체계 확립입니다. AI 모델은 예상치 못한 환각, 편향성, 데이터 유출, 지적재산권 침해 등 다차원적 위험 요소(Risk)를 동반하기 때문입니다. 체계적인 위험 관리가 부재한 상태로 배포된 AI 모델은 기업에게 커다란 법적·윤리적·재무적 손실을 초래할 수 있습니다.
거버넌스 체계 수립과 실무 체크리스트
조직 내 거버넌스를 정착시키기 위해서는 전사적 차원의 책임 구조 설정과 정량적 평가 절차가 선행되어야 합니다. 다음은 실무 현장에서 즉시 적용할 수 있는 거버넌스 점검 항목입니다.
- 책임 주체 명확화: AI 서비스별 최고 책임자(CISO/CTO), 데이터 소유자, 거버넌스 실무 위원회를 지정하고 역할 범위를 규정합니다.
- 위험성 분류 및 영향평가: 서비스 영역별 안전성, 개인정보 침해 가능성, 편향 위험도를 상·중·하 단계로 등급화하여 관리합니다.
- 데이터 접근 및 RBAC 권한 관리: 최소 권한 원칙(Principle of Least Privilege, PoLP)을 기반으로 사용자 역량별 데이터 접근을 차단합니다.
- 이상 징후 상시 모니터링: 성능 저하(Model Drift), 환각 발생률, 오남용 시도를 정기적으로 감사하고 정량화 지표로 기록합니다.
- 비상 응답 및 패치 정책: 부적절한 답변 유출 시 즉시 모델을 롤백(Rollback)하거나 샌드박스로 격리하는 표준운영절차(SOP)를 수립합니다.
NIST AI RMF 프레임워크 준수 가이드
미국 국립표준기술연구소(NIST)의 AI Risk Management Framework(AI RMF 1.0)는 AI 시스템의 전 생애주기에 걸쳐 신뢰성을 확보할 수 있는 대표적인 프레임워크를 제공합니다. NIST RMF는 식별(Govern), 측정(Map), 관리(Measure), 대응(Manage)의 4대 핵심 축으로 구성되어 있습니다. 조직은 단발성 평가에 그치지 않고 개발 초기 프로토타입부터 운용 단계까지 체계적인 모니터링 프로세스를 통합해야 컴플라이언스 리스크를 예방할 수 있습니다. (nvlpubs.nist.gov)
2. 규제 환경과 준수 포인트
글로벌 AI 규제 환경은 매우 빠른 속도로 구체화되고 있으며, 이는 국내외 사업을 운영하는 모든 기업에게 직접적인 영향력을 행사합니다. 특히 법적 제재 수준이 높아짐에 따라 사전에 적합성 평가 기준을 분석하여 대비하는 것이 중요합니다.
EU AI Act와 고위험 AI 컴플라이언스
유럽연합(EU)의 AI 법안(AI Act)은 2024년 8월 1일부로 발효되어 세계에서 가장 엄격한 AI 규제 기준을 제시하고 있습니다. EU AI Act는 위험도에 따라 금지 대상, 고위험(High-Risk), 제한적 위험, 최저 위험 단계로 AI 시스템을 분류합니다. 고위험 AI 시스템에 해당하는 경우, 기술 문서화, 고품질 학습 데이터셋 요약, 시스템 투명성 확보, 위험 관리 시스템 구축 및 최소 6개월 이상의 로그 보존 의무가 적용됩니다. 글로벌 서비스를 준비하는 조직은 적합성 평가 절차와 기술 문서 양식을 사전 구비해야 합니다. (commission.europa.eu)
3. Retrieval‑Augmented Generation(RAG): 원리와 실제
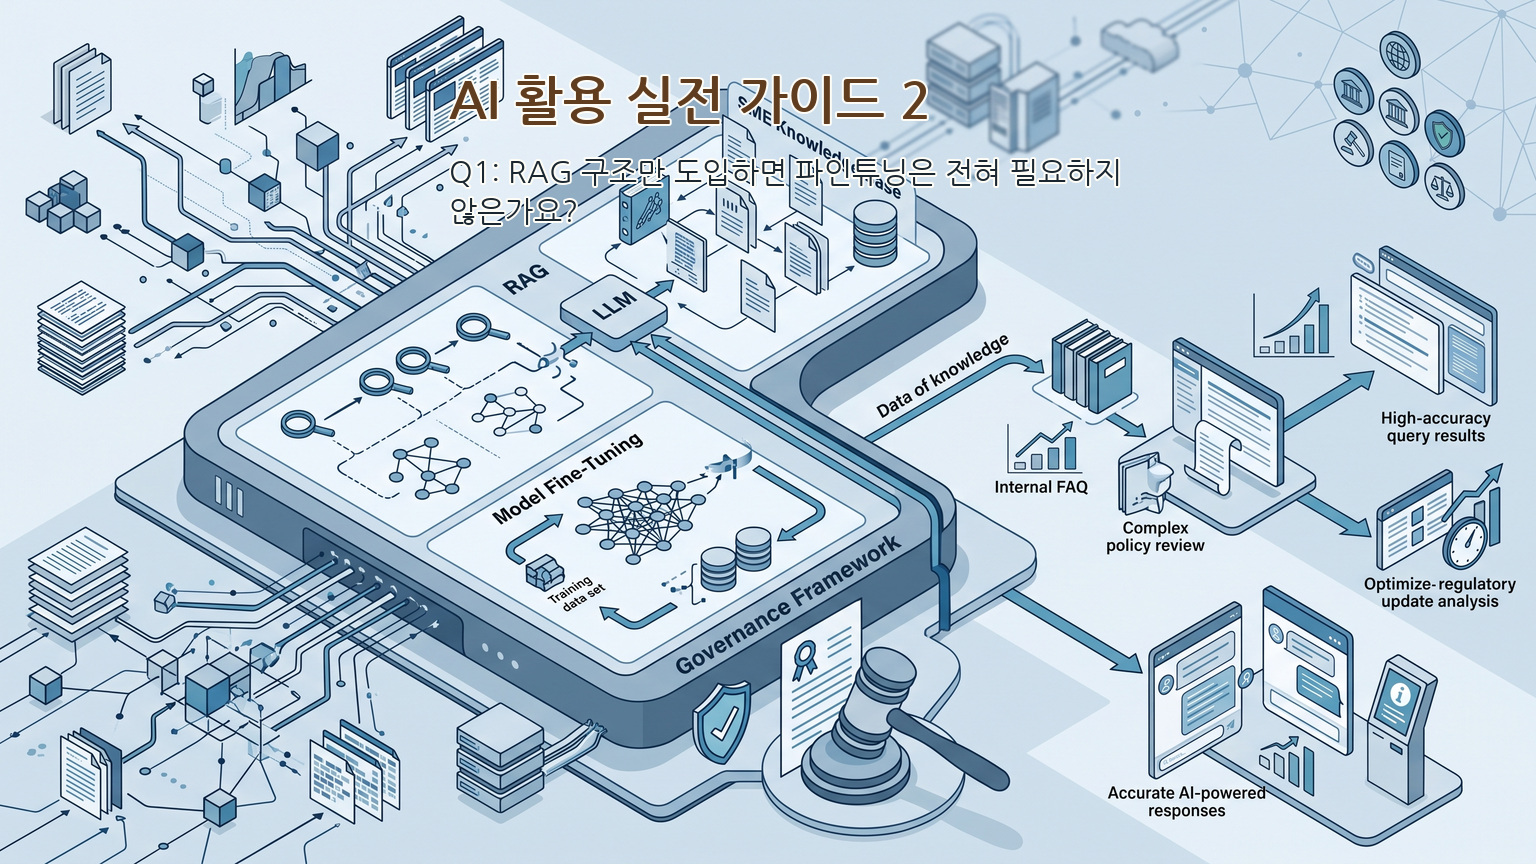
RAG(검색 증강 생성)는 대형 언어 모델(LLM)이 가진 내재적 한계인 최신 정보 부재와 환각 현상을 해결하는 대표적인 아키텍처입니다. 외부의 검증된 문서 DB나 전문 데이터베이스에서 관련 정보를 실시간 검색(Retrieval)한 후, 이를 LLM의 맥락(Context)으로 주입하여 근거 기반(Grounded)의 정밀한 답변을 생성하게 만듭니다. RAG 구조 연구는 2020년 Lewis 등의 논문을 통해 체계적으로 정립되었습니다. (arxiv.org)
RAG(Retrieval-Augmented Generation) 설계의 핵심 요소
성공적인 RAG 아키텍처 구축을 위해서는 개별 파이프라인 요소들의 최적화가 필수적입니다.
- 문서 정제 및 메타데이터 설계: PDF, HWPX, HTML 등 정형·비정형 문서를 표준화하고 작성일, 보안등급, 문서 ID 등 메타데이터를 정교하게 부과합니다.
- 의미적 청킹(Semantic Chunking): 문단을 500~1,000 토큰 단위의 자연스러운 의미 덩어리로 나누고, 맥락 유실을 방지하기 위해 10~15% 내외의 오버랩(Overlap) 구간을 포함시킵니다.
- 임베딩 및 하이브리드 검색: 도메인 특화 임베딩 모델을 활용하여 벡터 인덱싱을 수행하며, 정확한 키워드 매칭을 위한 BM25 알고리즘과 의미론적 벡터 검색을 병행하는 하이브리드 검색을 구현합니다.
- 재순위화(Reranking): 검색된 상위 결과들을 Cross-Encoder 기반 Reranker로 재평가하여 관련도가 높은 문서만 프롬프트에 주입합니다.
- 출처(Citation) 자동 생성: 답변의 신뢰도를 높이기 위해 출력 내용 각 문장 끝에 참조한 문장/문단 번호와 문서 링크를 명시합니다.
특히 실무 환경에서는 벡터 인덱싱 시 단일 임베딩 모델에 의존하기보다, 도메인 용어집(Glossary)을 활용한 정적 사전 빌드와 동적 메타데이터 필터링을 결합함으로써 검색 회수율(Recall)과 정밀도(Precision) 간의 균형을 극대화해야 합니다.
클라우드 도구 예시 및 인프라 구성 — Vertex AI
자체적인 RAG 파이프라인 구축 외에도 클라우드 매니지드 플랫폼을 도입하면 구축 기간과 인프라 관리 부담을 크게 줄일 수 있습니다. 대표적으로 Google Cloud의 Vertex AI는 데이터 임베딩, 고성능 Vector Search(매칭 엔진), RAG 엔드포인트를 하나로 통합한 솔루션을 제공합니다. 인프라 운영 관리의 부담을 줄이면서도 신속한 프로토타이핑과 높은 가용성을 보장하는 장점이 있습니다. (docs.cloud.google.com)
4. 파인튜닝(미세조정) 실전 절차
파인튜닝은 사전 학습된 기초 모델(Foundation Model)에 특정 산업 도메인의 고품질 데이터셋을 추가 학습시켜 모델의 출력 양식, 말투, 전문 지식 수행 능력을 고도화하는 기법입니다. RAG가 ‘외부 참고서 참조’라면 파인튜닝은 ‘모델 자체의 암기 및 응답 스타일 교정’에 해당합니다.
파인튜닝(미세조정) 실전 단계별 가이드
파인튜닝 프로젝트는 정교하게 구성된 단계를 거쳐 진행되어야 비용 손실과 성능 저하를 방지할 수 있습니다.
- 목표 KPI 설정: 단순 정확도 외에도 응답 일관성, 응답 지연 시간(Latency), 추론 비용 절감 목표를 명확하게 수립합니다.
- 고품질 데이터셋 제작: 질문-답변(Q&A) 구조의 JSONL 포맷 데이터를 최소 수천 건 이상 확보하고, 개인정보 제거 및 라벨링 편향 검증을 수행합니다.
- 소규모 하이퍼파라미터 실험: 학습률(Learning Rate), 에포크(Epoch), 배치를 조절하며 LoRA/QLoRA 등 경량화 파인튜닝 기법을 활용해 비용 대비 성능을 점검합니다.
- 다차원 검증: BLEU, ROUGE 등 자동 평가 지표와 함께 도메인 전문가의 정책 위반·유해성 검토를 동시 실시합니다.
- 배포 및 A/B 테스트: 기존 모델과 파인튜닝 모델을 유저 트래픽 기반으로 비교 분석한 후 모니터링 하에 점진적 롤아웃을 진행합니다.
실무 적용 시 LoRA/QLoRA와 같은 경량 파인튜닝 기법을 사용할 때에는 Rank(r)와 Alpha 파라미터 최적화를 위해 최소 3회 이상의 검증 세트 반복 평가를 거치는 것이 바람직합니다. 이를 통해 메모리 사용량을 절반 이하로 줄이면서도 베이스 모델 대비 응답 특성을 효과적으로 고도화할 수 있습니다.
파인튜닝 데이터 구축 및 시 유의사항
파인튜닝 과정에서는 일반화 성능이 오염되거나 과적합(Overfitting)이 발생하는 현상을 극복해야 합니다. 데이터셋 수집 시 타인의 저작물이나 비공개 개인정보가 입력되지 않도록 데이터 클렌징을 철저히 해야 합니다. OpenAI 등 주요 AI 플랫폼 도구에서도 정형화된 JSONL 데이터 구조 준수와 정교한 시스템 프롬프트 조합을 권장하고 있습니다. (platform.openai.com)
5. 실무 적용 예시(케이스 스터디 요약)
AI 아키텍처는 조직의 비즈니스 목적과 보유 데이터의 성격에 따라 다르게 구성되어야 합니다. 아래의 대표 사례를 통해 실제 시스템 결합 구조를 참조할 수 있습니다.
사례 A — 내부 지식 기반 고객지원 챗봇
- 도입 목적: 텍스트 기반 사내 FAQ 및 고객 상담 업무 응답 정확도를 80%에서 95% 수준으로 향상.
- 아키텍처 구성: 사내 운영 매뉴얼 PDF 파싱 파이프라인 + Vector Search 인덱스 + RAG 기반 LLM 응답 요약.
- 운영 성과 및 포인트: 모든 답변에 관련 사내 규정 문서 ID 표기, 문서 변경 시 실시간 인덱스를 업데이트하는 자동화 파이프라인 수립.
사례 B — 규제 문서 자동요약 (법무 부서 지원)
- 도입 목적: 복잡한 국제 방침 및 규제 개정안 검토 시간 감축 (건당 30분 → 10분 단축).
- 아키텍처 구성: 판례·법령 DB 기반의 하이브리드 RAG + 법률 전문 스타일로 파인튜닝된 요약 LLM 연동.
- 운영 성과 및 포인트: 최종 오답 위험 방지를 위해 법률 전문 승인 프로세스(Human-in-the-loop)와 법적 책임 고지문 부과.
6. 주의점과 한계
AI 기술을 도입할 때 기술이 가진 원천적인 한계점을 명확히 파악하지 않으면 예상치 못한 서비스 장애나 컴플라이언스 이슈에 직면하게 됩니다.
환각(Hallucination) 방지 및 안전 메커니즘
LLM은 정답을 알지 못할 때도 연관되어 보이는 가짜 정보를 사실처럼 답변하는 환각(Hallucination) 특성을 보입니다. 이를 완화하기 위해서는 Natural Language Inference(NLI) 기반 충실도 평가 모듈을 도입하고, 검색된 컨텍스트와 생성된 답변 간 유사도가 설정된 임계값(Threshold) 미만일 경우 “관련 정보를 찾을 수 없습니다”와 같이 답하는 폴백(Fallback) 메커니즘을 적용해야 합니다. 또한 정기적인 시스템 감사 로그 보존 및 적합성 검토를 지속해야 안정적인 서비스 유지가 가능합니다.
7. 운영 체크리스트 — 배포 전/후
AI 서비스를 프로덕션 환경에 성공적으로 안착시키기 위해 단계별 필수 점검 사항을 지속적으로 이행해야 합니다.
엔터프라이즈 AI 배포 전후 운영 체크리스트
- 배포 전 단계: 위험평가 보고서 승인, 보안 패치 완료 여부, 오프라인 평가 벤치마크 통과, 법률 검토 완료, 긴급 비상 롤백 솔루션 준비.
- 배포 후 단계: 응답 신뢰도 실시간 관제, 인프라 응답 지연(Latency) 추적, 사용자 피드백(좋아요/나빠요) 수집, 모니터링 기반 분기별 데이터 갱신.
배포 이후에는 실시간 텔레메트리 데이터를 기반으로 프롬프트 토큰 수, 응답 지연 시간(P95/P99), 사용자 피드백을 상시 관제해야 하며, 주 단위 모델 드리프트(Model Drift) 감지를 위한 평가 파이프라인 자동화가 필수적입니다.
8. 도구·플랫폼 비교 포인트
기업의 환경(온프레미스 vs SaaS vs VPC 클라우드)에 따라 최적의 기술 스택을 선택하는 기준이 달라집니다.
AI 플랫폼 및 도구 선택 비교 포인트
플랫폼 평가 시에는 단순한 알고리즘 성능 외에도 인프라 확장성과 운영 편의성을 다각도로 검토해야 합니다.
- 검색 및 임베딩 성능: 한국어 등 다국어 처리 정밀도(Precision)와 회수율(Recall) 검증.
- 데이터 주권 및 보안: 데이터가 외부에 저장되지 않고 온프레미스 또는 프라이빗 Cloud VPC 환경 내에서만 처리되는지 확인.
- 통합 개발 환경: API, SDK, 모니터링 패널 등 개발 환경 통합 지원 유무.
- 비용 구조 계산: 벡터 DB 저장 공간 요금, 임베딩 호출 비용, LLM 토큰 추론 요금의 종합적 비교.
9. FAQ
Q1: RAG 구조만 도입하면 파인튜닝은 전혀 필요하지 않은가요?
A: 아닙니다. 두 기술은 상호보완적입니다. 최신 정보나 내부 문서를 참조할 때는 RAG가 필수적이며, 서비스만의 특수한 말투, 출력 양식, 고도의 전문 도메인 추론 능력이 필요할 때는 파인튜닝을 함께 조합하는 것이 가장 이상적입니다.
Q2: 파인튜닝 진행 시 필요한 최소 데이터 규모는 어느 정도인가요?
A: 작업의 복잡도에 따라 다르지만, 일반적인 서식 정렬이나 스타일 지정은 고품질 데이터 500~1,000건으로도 가시적인 성과를 볼 수 있습니다. 그러나 깊은 도메인 지식 학습을 위해서는 수만 건 이상의 정제된 데이터셋이 필요할 수 있습니다.
Q3: 해외 규제(EU AI Act 등)가 국내 기업의 내부 서비스에도 적용되나요?
A: 기업의 서비스 대상에 EU 거주자가 포함되거나 해외 사업장에 적용될 경우 역외 적용권에 의해 직접적인 규제 대상이 됩니다. 따라서 글로벌 확장을 고려한다면 초기 설계 단계부터 규제 컴플라이언스 체계를 마련하는 것이 안전합니다.
10. 핵심 정리
- 거버넌스: NIST AI RMF 등 글로벌 프레임워크를 수용하여 위험 관리 절차를 제도화하세요.
- RAG: 의미적 청킹과 하이브리드 검색을 구성하고, 명확한 출처 표기 메커니즘을 도입하세요.
- 파인튜닝: 고품질 데이터 정제와 소규모 실험을 기반으로 비용 대비 효과를 선검증하세요.
- 규제 준수: EU AI Act 등 주요 규제 요구사항에 따른 기술 문서화와 로그 보존 체계를 완성하세요.
출처
- Artificial Intelligence Risk Management Framework (AI RMF 1.0) — NIST (PDF)
- AI Act enters into force — European Commission (news, 1 Aug 2024)
- Fine-tuning | OpenAI API Reference
- Retrieval-Augmented Generation for Knowledge-Intensive NLP Tasks (RAG) — arXiv (Lewis et al., 2020)
- RAG quickstart | Generative AI on Vertex AI — Google Cloud Documentation
- www.nist.gov
- help.openai.com
- www.nist.gov