주식 시장의 변동성이 극심해지면서 주관적인 감정이나 뉴스 소음에 흔들리지 않고 냉정한 데이터에 기반해 투자하려는 수요가 급증하고 있습니다. 과거에는 정량적인 재무 지표나 기술적 지표를 규칙으로 만들어 매매하는 ‘전통적 퀀트(Quant) 투자’가 주를 이루었다면, 최신 시장에서는 머신러닝과 거대언어모델(LLM)을 결합한 AI 퀀트 투자가 새로운 패러다임으로 부상하고 있습니다.
하지만 ‘AI’와 ‘퀀트’라는 두 가지 높은 진입장벽이 합쳐지면서 초보 투자자들은 무엇부터 시작해야 할지 막막함을 느끼곤 합니다. 단순히 ‘컴퓨터가 자동으로 돈을 벌어준다’는 환상에 빠져 접근했다가 과거 데이터에 지나치게 맞춘 ‘과적합(Overfitting)’의 함정에 빠져 손실을 보는 사례도 적지 않습니다.
본 가이드에서는 AI 퀀트 투자의 기본 정의부터 전통 퀀트와의 차이점, 핵심 알고리즘 구조, 과적합 방지 전략, 그리고 초보자가 체계적으로 구축할 수 있는 실전 4단계 운용 파이프라인과 자주 묻는 질문(FAQ)까지 체계적으로 해설해 드립니다.
1. AI 퀀트 투자란 무엇인가?
퀀트(Quantitative) 투자란 직관이나 소문 대신 수학·통계학적 모델과 정량적 데이터를 바탕으로 투자 판단을 내리는 방식을 의미합니다. 주가수익비율(PER), 주가순자산비율(PBR), 모멘텀 등 숫자로 측정 가능한 지표(팩터)를 기반으로 매수·매도 규칙을 수립하고, 이를 기계적으로 실행하는 것이 핵심입니다.
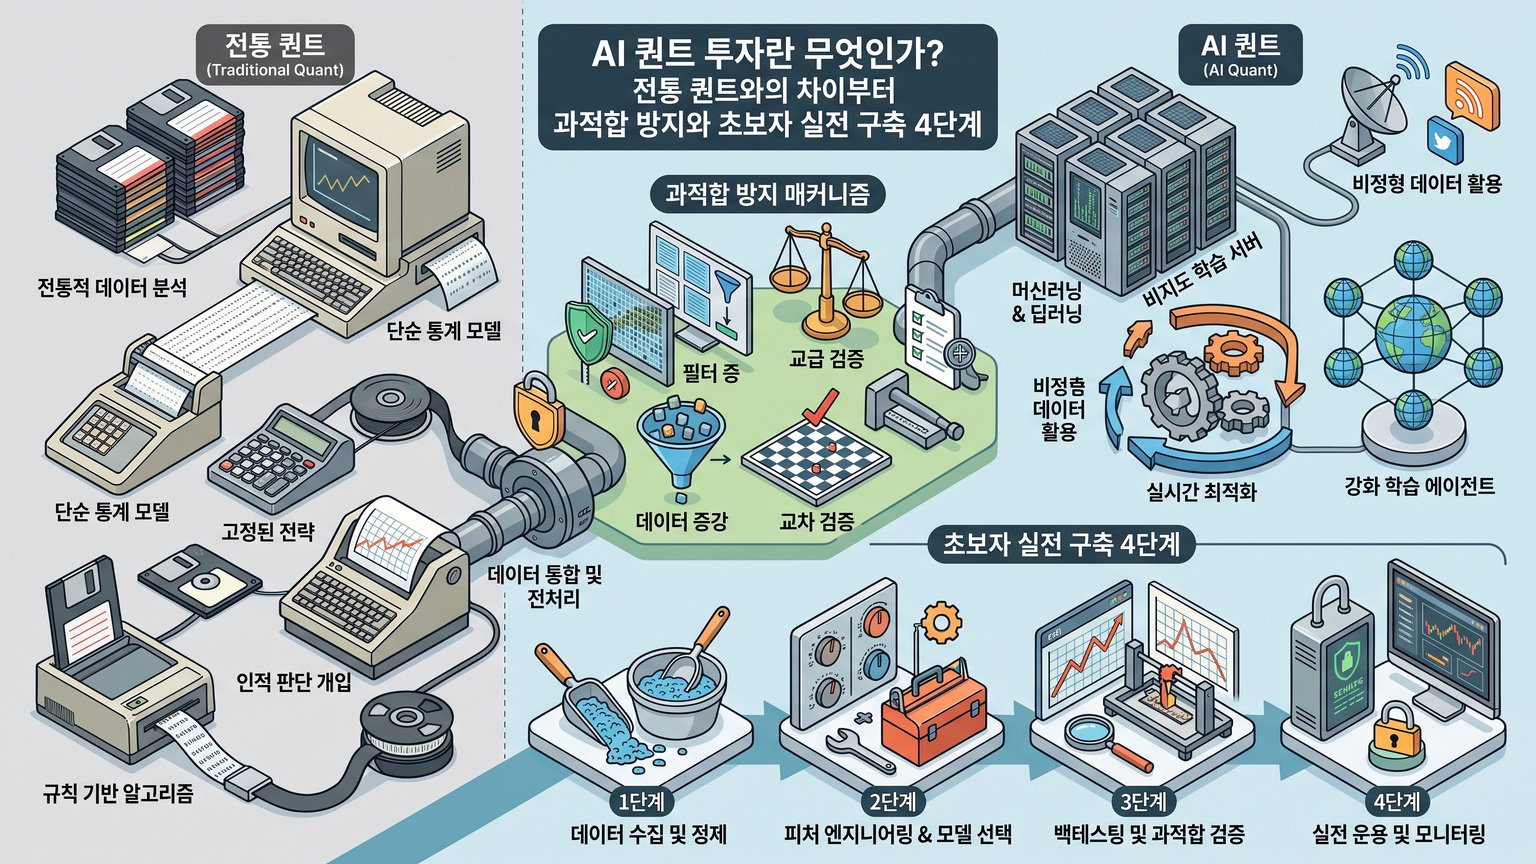
여기서 한 단계 더 진화한 AI 퀀트 투자는 정형화된 규칙을 인간이 직접 작성하는 대신, 머신러닝(Machine Learning), 딥러닝(Deep Learning), 자연어 처리(NLP) 등의 인공지능 기술이 직접 방대한 데이터를 학습하여 복잡한 패턴을 발견하고 매매 신호를 생성하는 방식입니다.
즉, 전통 퀀트가 ‘인간이 세운 가설과 규칙을 컴퓨터가 빠르게 계산하는 방식’이라면, AI 퀀트는 ‘데이터 속에 숨겨진 비선형적 관계와 상관관계를 AI가 직접 찾아내 자율적으로 모델을 업데이트하는 방식’이라고 정의할 수 있습니다. AI 퀀트는 사람의 심리적 편향인 공포와 탐욕을 배제하고, 초단기 타임프레임부터 장기 자산배분까지 전 주기적인 투자 의사결정을 자동화할 수 있는 강력한 무기입니다.
2. 전통 퀀트 vs AI 퀀트: 핵심 차이점 분석
전통 퀀트와 AI 퀀트는 투자 결정을 내리는 엔진의 구조와 다루는 데이터의 범주에서 명확한 차이를 보입니다. 구체적인 차이점을 데이터와 데이터 구조 측면에서 나누어 분석해 보겠습니다.
가. 데이터 처리 범위의 확장 (정형 vs 비정형 데이터)
전통 퀀트는 주로 재무제표 수치, 주가, 거래량 등 수치화된 ‘정형 데이터(Structured Data)’ 분석에 집중했습니다. 이러한 데이터는 엑셀이나 SQL 데이터베이스 형태로 정돈되어 있어 다루기 쉽지만, 시장 전체에 이미 퍼진 후행적 지표라는 한계가 있습니다.
반면 AI 퀀트는 뉴스 기사, 공시 서류, 기업 실적 발표 음성, SNS 언급량, 위성 사진 데이터 등 텍스트와 이미지 형태의 ‘비정형 데이터(Unstructured Data)’까지 실시간으로 해석합니다. 자연어 처리(NLP) 모델 및 LLM을 통해 시장의 투자 심리(Sentiment)를 즉각 수치화하여 기존의 정형 데이터와 결합함으로써 시장 선행 지표로서의 알파(초과 수익)를 창출해 냅니다.
나. 선형적 모델 vs 비선형적 상관관계 포착
전통 퀀트는 ‘저PER 주식을 사서 1년 보유한다’거나 ’20일 이동평균선이 60일 이동평균선을 골든크로스할 때 매수한다’와 같이 비교적 단순하고 선형적인 정량 규칙을 따릅니다. 그러나 현실 금융 시장은 거시경제 지표, 금리 변동, 기업 실적, 거래량, 지정학적 리스크 등이 복잡하게 얽혀 선형 방정식으로 풀기 어려운 비선형적 특성을 띱니다.
AI 퀀트의 머신러닝 알고리즘(Random Forest, XGBoost, LightGBM, LSTM 등)은 수십, 수백 개의 독립 변수 간에 존재하는 복잡한 비선형적 상호작용과 시계열적 특성을 스스로 감지합니다. 시장 상황이 급변할 때 변수 간의 중요도 weights를 동적으로 수정하여 보다 유연하고 정교한 매매 포트폴리오를 구성한다는 점이 결정적인 차이점입니다.
3. AI 퀀트 알고리즘의 3대 핵심 구성요소
성공적인 AI 퀀트 시스템은 단순한 매매 프로그램이 아니라, 데이터 수집부터 분석, 포트폴리오 비중 결정, 주문 실행까지 유기적으로 연결된 3가지 핵심 모듈로 구성됩니다.
가. 알파 생성 모듈 (Alpha Generation)
시장 평균 수익률을 초과하는 ‘알파(Alpha)’를 발굴하는 알고리즘 엔진입니다. 재무 팩터, 기술적 지표, 뉴스 감성 분석 지표, 거시경제 지표 등을 머신러닝/딥러닝 모델에 입력하여 향후 특정 기간 동안의 주가 상승 확률이나 기대 수익률을 예측합니다.
최신 알파 생성 모듈은 GPT-4o나 Claude 같은 거대언어모델(LLM)을 활용해 DART 공시 서류나 미국 SEC 10-K, 10-Q 보고서를 실시간으로 요약하고 긍정/부정 뉘앙스를 수치화하는 정교한 NLP 파이프라인을 탑재하고 있습니다. 이를 통해 타 투자자보다 훨씬 빠르게 공시 악재나 호재를 가격에 반영할 수 있습니다.
나. 리스크 관리 및 포트폴리오 최적화 모듈 (Risk Management)
아무리 알파 생성 모듈이 우수한 상승 유망 종목을 발굴하더라도, 적절한 위험 관리가 수반되지 않으면 단 한 번의 블랙스완이나 시장 충격에 포트폴리오 전체가 회복 불능의 손실을 입을 수 있습니다.
리스크 관리 모듈은 평균-분산 최적화(Mean-Variance Optimization), 평균 손실 최소화, 또는 강화학습(Reinforcement Learning) 알고리즘을 활용해 각 자산의 위험 대비 수익비를 정교하게 산출합니다. 개별 종목의 변동성, 종목 간 상관계수, 최대 낙폭(MDD, Maximum Drawdown), VaR(Value at Risk)을 실시간 측정하며, 특정 섹터나 특정 팩터에 자산이 과도하게 쏠리지 않도록 제어하는 리밸런싱 포지션을 자동 산출합니다.
다. 주문 집행 및 실행 모듈 (Execution Module)
포트폴리오 최적화를 통해 최종 매매 종목과 수량이 결정되면 증권사 Open API와 연동하여 실제 주문을 금융 시장에 송신하는 모듈입니다.
대량 주문을 일시에 투입할 경우 발생하는 시장 충격 비용(Market Impact)과 슬리피지(Slippage, 주문가와 실제 체결가의 차이)를 최소화하기 위해 TWAP(시간분할균등주문)이나 VWAP(거래량가중평균주문) 등 고급 알고리즘 트레이딩 기법이 적용됩니다. AI는 실시간 호가창(Order Book) 데이터의 잔량 변화와 체결 속도를 감지하여 가장 매수·매도 마찰 비용이 적은 최적의 시점에 분할 주문을 집행합니다.
4. AI 퀀트의 최대 적: 과적합(Overfitting) 방지 및 검증 전략
AI 퀀트 투자 개발 과정에서 초보자 및 시스템 개발자가 가장 자주 범하는 치명적인 실수는 과거 백테스트 데이터에서 완벽한 성과를 보인 모델이 미래 실전에서도 동일한 수익을 가져다줄 것이라 착각하는 ‘과적합(Overfitting)’ 현상입니다. 과거 시장 데이터에 존재하는 임의의 노이즈와 일시적 무작위 패턴까지 AI 모델이 과도하게 학습하면, 실제 시장 투입 시 처참한 손실을 기록하게 됩니다.
가. 데이터 편향 통제와 데이터 위생
과적합을 막기 위한 첫 단추는 데이터 수집 과정에서 각종 편향(Bias)을 엄격히 통제하는 ‘데이터 위생(Data Hygiene)’ 절차를 거치는 것입니다.
- 생존 편향(Survivorship Bias): 현재 상장되어 있는 종목만을 대상으로 과거 데이터를 조회하면, 과거에 상장 폐지되거나 부도난 부실 기업들이 제외되어 수익률이 과대평가됩니다. 따라서 상장 폐지된 종목까지 모두 포함한 포인트-인-타임(Point-in-Time) 데이터베이스를 사용해야 합니다.
- 룩어헤드 편향(Look-ahead Bias): 과거 특정 시점에는 알 수 없었던 미래 정보(예: 3월 31일 자 재무제표가 실제 공시된 날짜는 5월 15일인데, 3월 31일부터 해당 재무 수치를 이용해 매매한 것으로 계산하는 오류)를 백테스트에 포함하는 실수를 완벽히 차단해야 합니다.
나. 전진 분석(Walk-Forward Optimization)과 앙상블 기법
시계열 데이터 분석에서는 단순히 무작위로 데이터를 나누는 K-Fold 교차 검증 대신, 시간의 흐름을 반영한 전진 분석(Walk-Forward Optimization) 기법을 반드시 적용해야 합니다.
예를 들어 과거 3년 데이터로 AI 모델을 학습(Train)시키고, 바로 이어지는 6개월 데이터로 검증(Validation/Test)을 진행한 뒤, 학습 및 검증 구간을 6개월씩 미래 방향으로 이동시키며 롤링 테스트를 반복하는 방식입니다. 이를 통해 시장 국면 변화(상승장, 하락장, 횡보장)에 대한 모델의 적응력과 강건성(Robustness)을 정확히 평가할 수 있습니다.
또한 XGBoost, LightGBM, Random Forest, Neural Network 등 서로 다른 작동 메커니즘을 가진 독립된 알고리즘의 예측 결과를 결합하는 앙상블(Ensemble) 기법 및 드롭아웃(Dropout), L1/L2 규제(Regularization)를 적용하면 단일 모델의 오판 및 노이즈 오버피팅 리스크를 대폭 낮출 수 있습니다.
5. 초보자 실전 AI 퀀트 구축 4단계 파이프라인
AI 퀀트 투자에 입문하는 초보자는 처음부터 무작위로 복잡한 딥러닝 알고리즘을 구현하려 하기보다, 검증된 4단계 파이프라인을 따라 단계별로 시스템을 체계화하는 것이 바람직합니다.
1단계: 투자 아이디어 정의 및 데이터 수집
먼저 명확하고 검증 가능한 투자 가설(예: